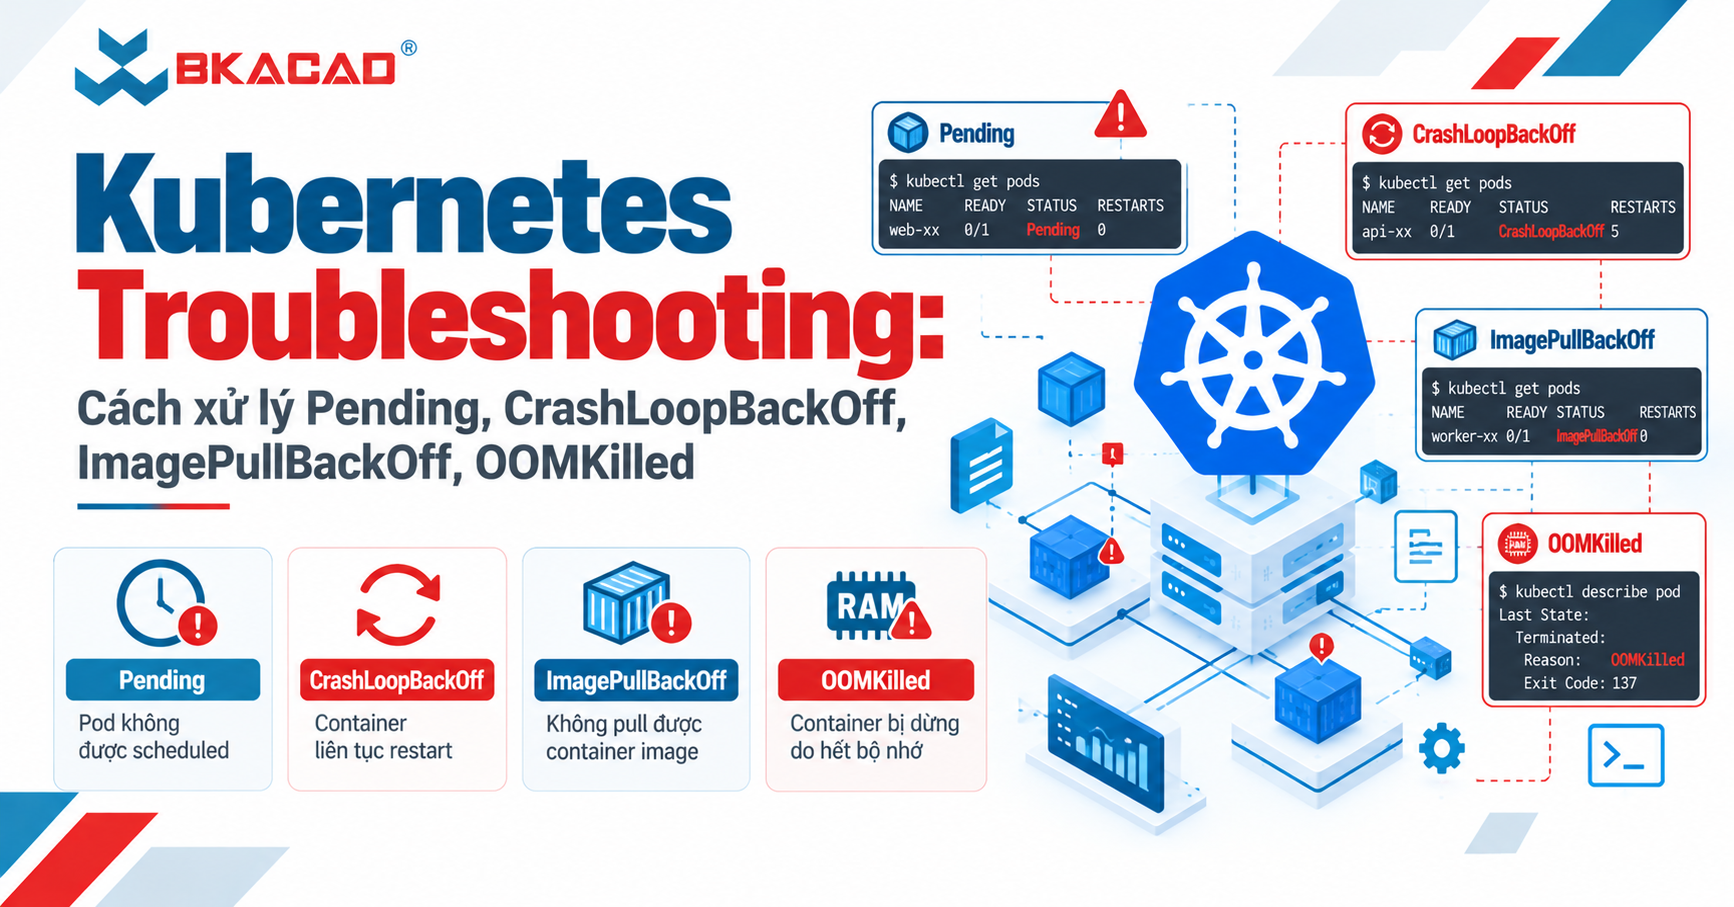
Trong quá trình triển khai và vận hành ứng dụng trên Kubernetes, việc gặp phải các sự cố liên quan đến Pod là điều khó tránh khỏi. Một ứng dụng có thể không được lên lịch chạy, container liên tục khởi động lại, không thể tải image hoặc bị hệ thống kết thúc do vượt quá giới hạn bộ nhớ. Những tình huống này không chỉ ảnh hưởng đến khả năng hoạt động của ứng dụng mà còn có thể gây gián đoạn dịch vụ nếu không được phát hiện và xử lý kịp thời.
Đối với Kubernetes Administrator, DevOps Engineer hay những người đang chuẩn bị cho kỳ thi Certified Kubernetes Administrator (CKA), Kubernetes Troubleshooting là một trong những kỹ năng quan trọng nhất cần thành thạo. Khác với việc triển khai ứng dụng theo cấu hình có sẵn, Troubleshooting yêu cầu người quản trị hiểu cơ chế hoạt động của Kubernetes, biết cách phân tích trạng thái hệ thống và xác định nguyên nhân gốc rễ của sự cố.
Trong số những lỗi thường gặp, Pending, CrashLoopBackOff, ImagePullBackOff và OOMKilled là bốn tình huống tiêu biểu mà người học Kubernetes cần hiểu rõ. Bài viết dưới đây sẽ phân tích nguyên nhân, phương pháp kiểm tra và cách khắc phục từng lỗi thông qua các câu lệnh thực hành.
1. Kubernetes Troubleshooting là gì? Vì sao quan trọng?
Kubernetes Troubleshooting là quá trình kiểm tra, phân tích và xử lý các vấn đề phát sinh trong quá trình triển khai, quản lý và vận hành Kubernetes Cluster. Các sự cố có thể xảy ra ở nhiều cấp độ, từ ứng dụng, container, Pod, Node đến Networking, Storage hoặc các thành phần thuộc Control Plane.
Điểm phức tạp của Kubernetes nằm ở việc một vấn đề có thể liên quan đến nhiều thành phần khác nhau. Ví dụ, khi một Pod không thể hoạt động, nguyên nhân có thể xuất phát từ việc thiếu tài nguyên CPU, cấu hình container image không chính xác, lỗi kết nối mạng hoặc ứng dụng bên trong container gặp sự cố.
Vì vậy, Troubleshooting không đơn thuần là sử dụng một vài câu lệnh để kiểm tra trạng thái Pod. Người quản trị cần xây dựng quy trình phân tích có hệ thống, bắt đầu từ việc xác định triệu chứng, thu thập thông tin, khoanh vùng nguyên nhân và lựa chọn phương án xử lý phù hợp.
Đây cũng là nhóm kiến thức có tỷ trọng lớn trong chương trình chứng chỉ CKA, bởi khả năng xử lý sự cố phản ánh trực tiếp năng lực vận hành Kubernetes trong môi trường thực tế.
2. Các câu lệnh Kubernetes Troubleshooting cần thành thạo
Trước khi tìm hiểu từng lỗi, người học cần làm quen với một số câu lệnh kubectl thường xuyên được sử dụng trong quá trình kiểm tra và xử lý sự cố.
| Câu lệnh | Chức năng |
|---|---|
kubectl get pods | Kiểm tra danh sách và trạng thái Pod |
kubectl describe pod | Xem thông tin chi tiết và các sự kiện liên quan đến Pod |
kubectl logs | Kiểm tra log của container |
kubectl logs --previous | Xem log của phiên container trước đó |
kubectl get events | Xem các sự kiện trong Kubernetes |
kubectl get nodes | Kiểm tra trạng thái Node |
kubectl top pod | Kiểm tra mức sử dụng CPU và RAM nếu có Metrics API |
kubectl get pvc | Kiểm tra trạng thái PersistentVolumeClaim |
Trong thực tế, một trong những câu lệnh hữu ích nhất là:
kubectl describe pod <pod-name> -n <namespace>Kết quả trả về cung cấp thông tin về trạng thái container, điều kiện Pod, Node được chỉ định, tài nguyên yêu cầu và các sự kiện liên quan. Phần Events thường giúp xác định nguyên nhân ban đầu của sự cố, đặc biệt với các lỗi Scheduling, Image Pull hoặc Volume.
Tuy nhiên, không nên phụ thuộc vào duy nhất một câu lệnh. Để xác định chính xác vấn đề, người quản trị cần kết hợp thông tin từ trạng thái Pod, Events, Logs và cấu hình tài nguyên.
3. Kubernetes Pod Pending: Nguyên nhân và cách khắc phục
Pod Pending là gì?
Pending là một trong những trạng thái thuộc vòng đời của Pod trong Kubernetes. Khi Pod ở trạng thái Pending, điều đó có nghĩa là Pod đã được Kubernetes chấp nhận nhưng chưa hoàn tất các bước cần thiết để có thể chạy.
Trong một số trường hợp, Pod chưa được Scheduler gán vào Node phù hợp. Ở những trường hợp khác, Pod đã được gán Node nhưng vẫn đang chờ các bước chuẩn bị như tải container image hoặc thiết lập môi trường thực thi.
Do đó, Pod Pending không đồng nghĩa với việc Cluster luôn thiếu tài nguyên. Cần kiểm tra thông tin cụ thể để xác định nguyên nhân.
Tìm hiểu thêm về Control Plane và Worker Node
Những nguyên nhân phổ biến khiến Pod Pending
Một trong những nguyên nhân thường gặp là Cluster không có đủ tài nguyên CPU hoặc RAM để đáp ứng Resource Requests của Pod. Khi đó, Scheduler không thể tìm được Node phù hợp để triển khai workload.
Ngoài ra, Pod có thể không được lên lịch do cấu hình Node Selector hoặc Node Affinity quá chặt chẽ, khiến không có Node nào đáp ứng điều kiện. Taints và Tolerations cũng có thể gây ra tình trạng tương tự nếu Pod không được phép chạy trên các Node hiện có.
Đối với những ứng dụng sử dụng PersistentVolumeClaim, việc PVC chưa được liên kết với PersistentVolume cũng có thể ảnh hưởng đến quá trình Scheduling hoặc chuẩn bị môi trường chạy Pod.
Cách kiểm tra và xử lý Pod Pending
Đầu tiên, kiểm tra trạng thái Pod:
kubectl get pods -n defaultSau đó, xem thông tin chi tiết:
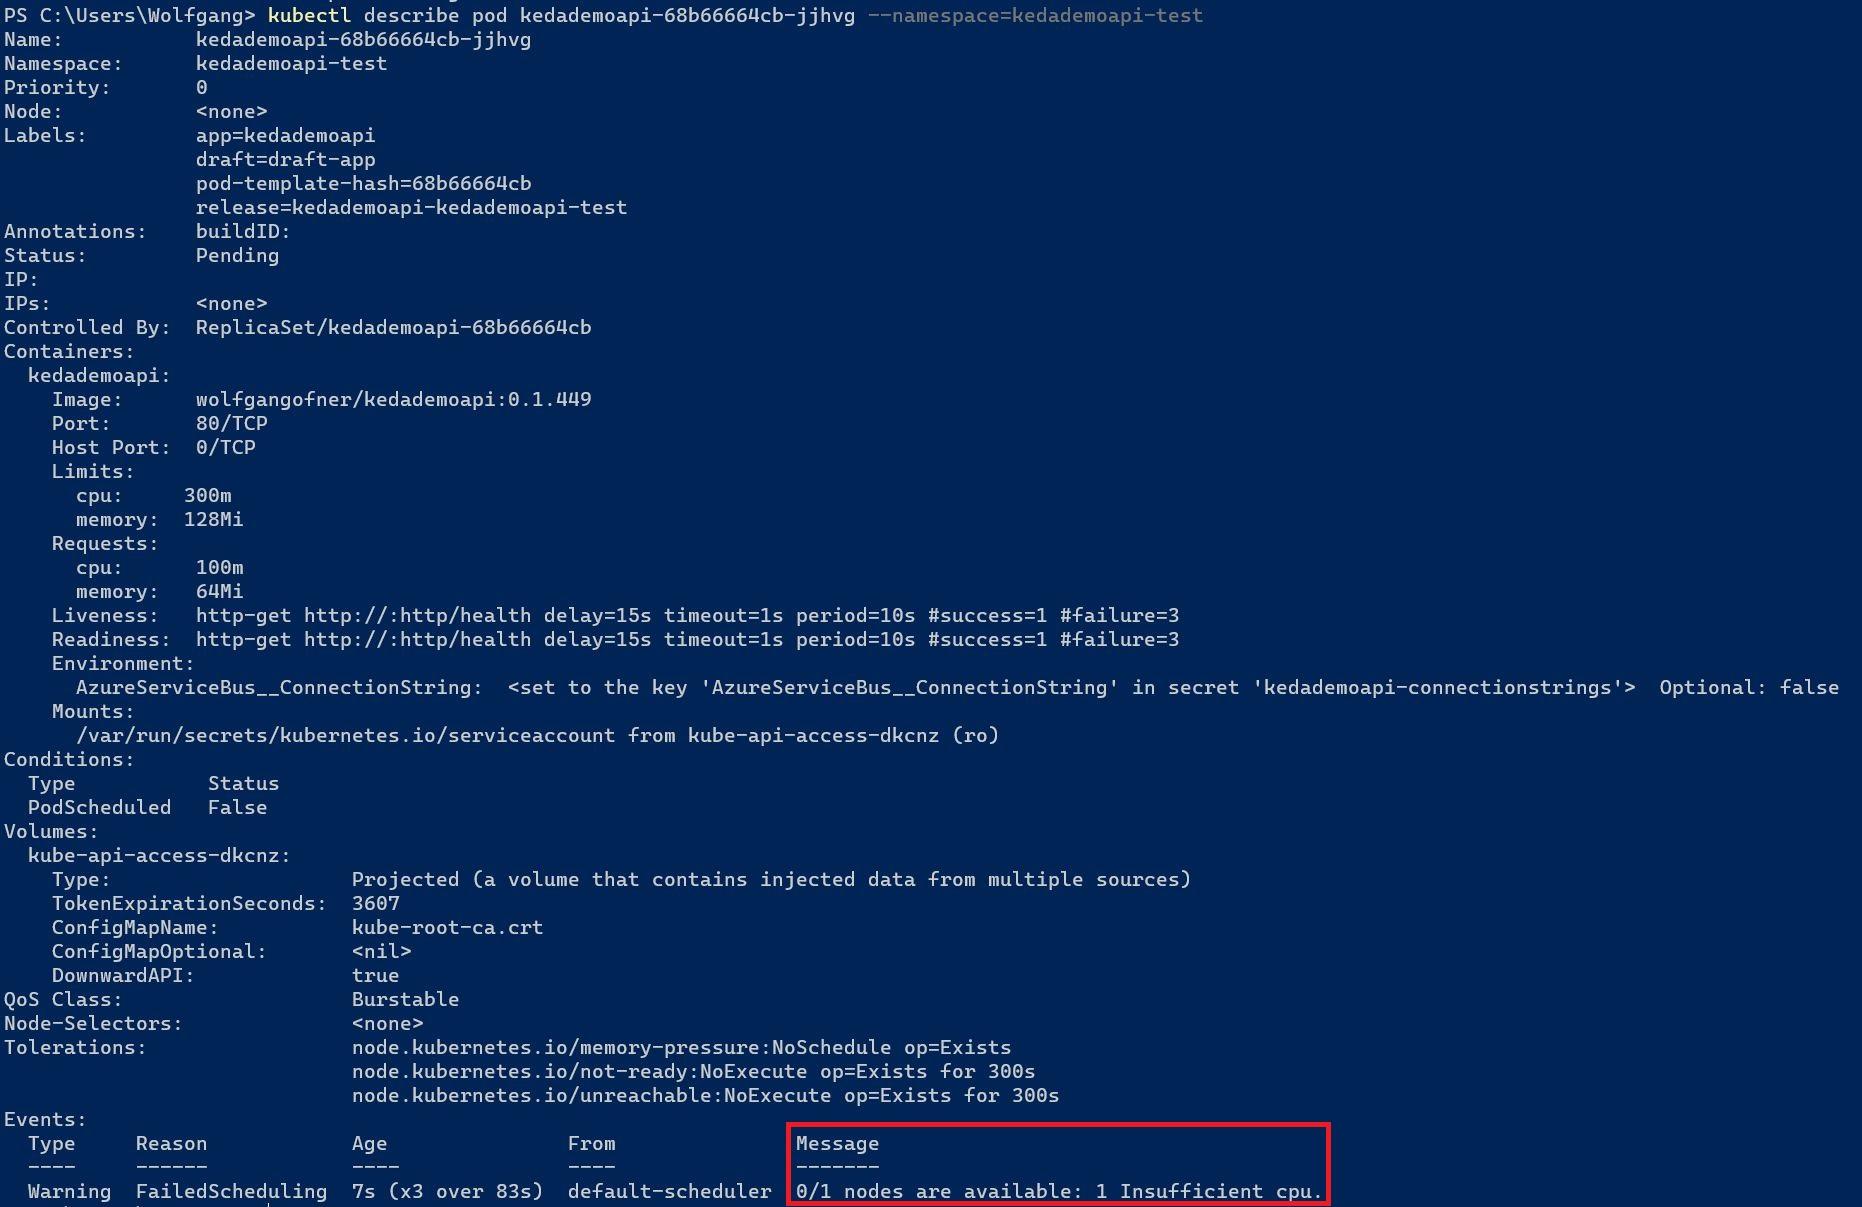
kubectl describe pod nginx-demo -n defaultNếu Pod chưa được lên lịch, phần Events có thể xuất hiện thông báo tương tự:
0/3 nodes are available:
3 Insufficient cpu.
Thông báo này cho thấy các Node hiện tại không đáp ứng được yêu cầu CPU của Pod.
Người quản trị cần kiểm tra Resource Requests trong cấu hình Pod và đối chiếu với tài nguyên có thể phân bổ trên các Node. Nếu yêu cầu tài nguyên cao hơn nhu cầu thực tế, có thể điều chỉnh cấu hình phù hợp. Nếu Cluster thực sự thiếu tài nguyên, cần cân nhắc bổ sung năng lực xử lý hoặc giải phóng tài nguyên không còn sử dụng.
Trong trường hợp lỗi liên quan đến Taints, có thể kiểm tra bằng:
kubectl describe node <node-name>Nếu vấn đề liên quan đến PVC, sử dụng:
kubectl get pvc -n defaultSau khi xác định nguyên nhân, cần xử lý đúng thành phần gây lỗi thay vì xóa Pod và tạo lại một cách máy móc.
4. CrashLoopBackOff là gì? Cách xử lý container liên tục khởi động lại
CrashLoopBackOff trong Kubernetes là gì?
CrashLoopBackOff là trạng thái thường xuất hiện khi một container liên tục kết thúc rồi được Kubernetes khởi động lại, đồng thời hệ thống áp dụng khoảng thời gian chờ tăng dần giữa các lần thử.
Cần phân biệt rằng CrashLoopBackOff không phải là một Pod phase độc lập. Đây là lý do chờ liên quan đến trạng thái container, thường được hiển thị trong kết quả kubectl get pods.
Tình trạng này thường xảy ra khi ứng dụng không thể khởi động thành công, tiến trình chính kết thúc bất thường hoặc container bị khởi động lại do cơ chế kiểm tra sức khỏe.
Nguyên nhân phổ biến của CrashLoopBackOff
Một nguyên nhân thường gặp là ứng dụng gặp lỗi trong quá trình khởi động, chẳng hạn thiếu file cấu hình, sai biến môi trường hoặc không thể kết nối đến một dịch vụ phụ thuộc.
Ngoài ra, container có thể bị khởi động lại do Liveness Probe được cấu hình không phù hợp. Nếu ứng dụng cần nhiều thời gian để khởi động nhưng Liveness Probe kiểm tra quá sớm, Kubernetes có thể liên tục kết thúc và khởi động lại container.
Các vấn đề liên quan đến bộ nhớ, quyền truy cập file hoặc câu lệnh khởi động container cũng có thể dẫn đến CrashLoopBackOff.
Hướng dẫn xử lý CrashLoopBackOff
Bước đầu tiên là kiểm tra trạng thái và số lần khởi động lại:
kubectl get pods -n defaultTiếp theo, kiểm tra log:
kubectl logs <pod-name> -n defaultNếu container đã khởi động lại, nên kiểm tra log của phiên trước:
kubectl logs <pod-name> -n default --previousĐối với Pod có nhiều container, cần bổ sung tham số -c để chỉ định container cần kiểm tra.
Sau đó, sử dụng:
kubectl describe pod <pod-name> -n defaultThông tin này giúp xác định trạng thái kết thúc trước đó, mã thoát của container, cấu hình Probe và các sự kiện liên quan.
Nếu nguyên nhân xuất phát từ ứng dụng, cần sửa lỗi cấu hình hoặc mã nguồn. Nếu vấn đề liên quan đến Liveness Probe, có thể điều chỉnh thời gian kiểm tra hoặc sử dụng Startup Probe để ứng dụng có đủ thời gian khởi động.
Không nên đơn giản tăng thời gian chờ hoặc vô hiệu hóa Probe mà chưa hiểu nguyên nhân thực tế, bởi điều đó có thể che giấu lỗi ứng dụng và làm giảm khả năng tự phục hồi của hệ thống.
5. ImagePullBackOff là gì? Cách khắc phục lỗi không tải được container image
ImagePullBackOff trong Kubernetes là gì?
ImagePullBackOff xuất hiện khi Kubernetes không thể tải container image cần thiết và đang chờ trước khi thực hiện lần thử tiếp theo.
Trạng thái này thường đi kèm với ErrImagePull trong quá trình container được chuẩn bị để chạy. Đây là lỗi liên quan đến quá trình truy xuất image, không nhất thiết xuất phát từ ứng dụng bên trong container.
Nguyên nhân khiến Kubernetes không thể tải image
Nguyên nhân phổ biến nhất là khai báo sai tên image hoặc image tag không tồn tại trong Container Registry.
Ví dụ, cấu hình sử dụng một tag không được phát hành có thể khiến Kubernetes không tìm thấy image tương ứng.
Ngoài ra, lỗi còn có thể xảy ra khi Container Registry yêu cầu xác thực nhưng Pod chưa được cấu hình ImagePullSecret phù hợp. Những vấn đề về DNS, kết nối mạng, giới hạn truy cập Registry hoặc lỗi chứng chỉ TLS cũng có thể ảnh hưởng đến quá trình tải image.
Cách kiểm tra và xử lý ImagePullBackOff
Đầu tiên, kiểm tra Pod:
kubectl get pods -n defaultSau đó, xem Events:
kubectl describe pod <pod-name> -n defaultMột thông báo lỗi có thể có dạng:
Failed to pull image "example/app:wrong-tag"Nếu lỗi liên quan đến image tag, cần kiểm tra lại tên image và phiên bản được khai báo trong Deployment hoặc Pod.
Có thể xem cấu hình hiện tại bằng:
kubectl get deployment <deployment-name> -n default -o yamlNếu sử dụng Private Registry, cần kiểm tra ImagePullSecret và bảo đảm Secret được tạo trong đúng Namespace, đồng thời được tham chiếu phù hợp trong cấu hình Pod hoặc ServiceAccount.
Trường hợp image hợp lệ nhưng vẫn không thể tải, người quản trị cần tiếp tục kiểm tra kết nối mạng, DNS và khả năng truy cập Registry từ Node.
Tìm hiểu thêm về Kubernetes RBAC
6. Kubernetes OOMKilled là gì? Cách xử lý lỗi thiếu bộ nhớ
OOMKilled trong Kubernetes là gì?
OOMKilled là trạng thái cho biết tiến trình container đã bị kết thúc do cơ chế Out of Memory (OOM). Trong Kubernetes, tình huống này thường liên quan đến việc container vượt quá giới hạn bộ nhớ được cấu hình hoặc gặp áp lực bộ nhớ ở cấp Node.
Khi một container bị OOMKilled, Kubernetes có thể khởi động lại container tùy theo Restart Policy. Nếu tình trạng tiếp tục lặp lại, Pod có thể xuất hiện CrashLoopBackOff.
Nguyên nhân phổ biến của OOMKilled
Một nguyên nhân thường gặp là Memory Limit được cấu hình thấp hơn mức sử dụng thực tế của ứng dụng.
Ví dụ, một ứng dụng Java cần sử dụng khoảng 700Mi bộ nhớ trong một giai đoạn xử lý, nhưng container chỉ được cấu hình giới hạn 512Mi. Khi mức sử dụng vượt giới hạn và không thể được đáp ứng, container có thể bị kết thúc.
Ngoài ra, ứng dụng bị Memory Leak, tải tăng đột biến hoặc cấu hình bộ nhớ không phù hợp cũng có thể dẫn đến OOMKilled.
Cách kiểm tra và xử lý OOMKilled
Đầu tiên, kiểm tra trạng thái container:
kubectl describe pod <pod-name> -n defaultNếu container bị OOMKilled, phần Last State có thể hiển thị:
Last State: Terminated
Reason: OOMKilled
Exit Code: 137
Lưu ý, Exit Code 137 không phải lúc nào cũng chứng minh container bị OOMKilled. Cần kết hợp với Reason, Events và thông tin tài nguyên để xác định chính xác.
Nếu Cluster có Metrics API, có thể kiểm tra mức sử dụng tài nguyên:
kubectl top pod <pod-name> -n defaultTiếp theo, kiểm tra cấu hình Resource Requests và Limits:
kubectl get pod <pod-name> -n default -o yamlVí dụ, một container có thể được cấu hình:
resources:
  requests:
    memory: "256Mi"
  limits:
    memory: "512Mi"
Nếu mức sử dụng bộ nhớ thực tế thường xuyên vượt 512Mi, cần đánh giá lại nhu cầu của ứng dụng. Trong một số trường hợp, việc tăng Memory Limit là cần thiết. Tuy nhiên, nếu nguyên nhân xuất phát từ Memory Leak, tăng giới hạn bộ nhớ chỉ có thể trì hoãn sự cố thay vì giải quyết triệt để.
Xem thêm: Công việc Kubernetes Administrator
Vì vậy, hướng xử lý hiệu quả cần kết hợp giữa kiểm tra cấu hình Kubernetes và phân tích mức sử dụng bộ nhớ của ứng dụng.
7. So sánh Pending, CrashLoopBackOff, ImagePullBackOff và OOMKilled
Bốn trạng thái trên có thể xuất hiện trong những giai đoạn khác nhau của quá trình triển khai và vận hành container. Việc hiểu sự khác biệt giúp người quản trị lựa chọn đúng hướng kiểm tra, tránh mất thời gian xử lý sai nguyên nhân.
| Trạng thái | Bản chất vấn đề | Nguyên nhân thường gặp | Hướng kiểm tra ưu tiên |
|---|---|---|---|
| Pending | Pod chưa hoàn tất điều kiện để chạy | Thiếu tài nguyên, Scheduling, PVC, chuẩn bị container | Pod Events, Node, PVC |
| CrashLoopBackOff | Container liên tục kết thúc và khởi động lại | Lỗi ứng dụng, Probe, cấu hình | Logs, Last State, Events |
| ImagePullBackOff | Không thể tải container image | Sai image, lỗi xác thực, mạng, Registry | Events, image, ImagePullSecret |
| OOMKilled | Tiến trình bị kết thúc do thiếu bộ nhớ | Memory Limit, Memory Leak, áp lực bộ nhớ | Last State, Metrics, Requests/Limits |
Cần lưu ý rằng các trạng thái này không hoàn toàn độc lập. Ví dụ, OOMKilled có thể khiến container liên tục khởi động lại và dẫn đến CrashLoopBackOff. Tương tự, một Pod ở trạng thái Pending có thể đang chờ container image được tải thành công.
Do đó, người quản trị cần phân tích toàn bộ quá trình hoạt động của Pod thay vì chỉ dựa vào một trạng thái hiển thị.
8. Quy trình Kubernetes Troubleshooting hiệu quả trong thực tế
Để xử lý sự cố Kubernetes một cách có hệ thống, có thể áp dụng quy trình gồm năm bước.
Bước 1: Xác định triệu chứng
Kiểm tra Pod, Deployment, Node và xác định tài nguyên đang gặp vấn đề.
Bước 2: Thu thập thông tin
Sử dụng
kubectl describe,kubectl logs, Events và Metrics để tìm dấu hiệu bất thường.Bước 3: Khoanh vùng nguyên nhân
Phân biệt vấn đề thuộc ứng dụng, container image, Scheduling, Networking, Storage hay hạ tầng.
Bước 4: Thực hiện phương án khắc phục
Điều chỉnh cấu hình hoặc xử lý thành phần gây lỗi, đồng thời cân nhắc tác động đến các workload khác.
Bước 5: Kiểm tra và phòng ngừa
Xác nhận hệ thống hoạt động ổn định, ghi nhận nguyên nhân và bổ sung biện pháp giám sát hoặc cảnh báo khi cần.
Một nguyên tắc quan trọng trong Kubernetes Troubleshooting là không nên thay đổi nhiều cấu hình cùng lúc khi chưa xác định được nguyên nhân. Việc điều chỉnh đồng thời nhiều thành phần có thể khiến quá trình đánh giá hiệu quả khắc phục trở nên khó khăn hơn, đồng thời làm phát sinh những vấn đề mới.
9. Vì sao Kubernetes Troubleshooting quan trọng trong kỳ thi CKA?
Certified Kubernetes Administrator (CKA) là chứng chỉ đánh giá năng lực quản trị Kubernetes thông qua các tác vụ thực hành. Trong chương trình CKA, Troubleshooting chiếm tỷ trọng 30%, cao nhất trong các nhóm kiến thức được đánh giá.
Tìm hiểu ngay: CKA có khó không?
Điều này cho thấy việc thành thạo các thao tác triển khai và cấu hình Kubernetes là chưa đủ. Người học còn cần có khả năng xác định nguyên nhân và khắc phục sự cố trong môi trường Cluster.
Những kỹ năng như đọc log, kiểm tra Events, phân tích trạng thái Node, xử lý lỗi Scheduling và xác định vấn đề liên quan đến tài nguyên đều có giá trị trong quá trình ôn luyện CKA.
Để chuẩn bị hiệu quả, người học nên thực hành trên môi trường Lab, chủ động tạo ra các lỗi cấu hình và tự giải quyết thay vì chỉ làm theo hướng dẫn có sẵn. Cách học này giúp phát triển tư duy phân tích hệ thống và nâng cao khả năng xử lý những tình huống chưa từng gặp.
10. Học Kubernetes Troubleshooting và quản trị Cluster tại BKACAD
Đối với những người muốn phát triển chuyên môn trong lĩnh vực DevOps, Cloud hoặc quản trị Kubernetes, việc thành thạo Troubleshooting là một phần quan trọng trong quá trình xây dựng năng lực thực hành.
Tại BKACAD – Học viện Công nghệ Bách Khoa, khóa học Certified Kubernetes Administrator (CKA) được xây dựng theo định hướng đào tạo kỹ năng triển khai, cấu hình, vận hành và xử lý sự cố Kubernetes.
Chương trình bao gồm những nội dung quan trọng như Cluster Architecture, Workloads & Scheduling, Services & Networking, Storage và Troubleshooting. Thông qua các bài thực hành Lab, học viên có cơ hội rèn luyện kỹ năng sử dụng kubectl, phân tích trạng thái hệ thống và giải quyết các tình huống quản trị Kubernetes.
Nếu đang tìm kiếm lộ trình học Kubernetes có hệ thống để nâng cao kỹ năng thực hành và chuẩn bị cho chứng chỉ quốc tế CKA, bạn có thể tham khảo chương trình đào tạo tại BKACAD:
Khóa học Certified Kubernetes Administrator (CKA) tại BKACAD
11. Kết luận
Kubernetes Troubleshooting là kỹ năng quan trọng đối với bất kỳ ai làm việc với hạ tầng Kubernetes, đặc biệt là Kubernetes Administrator, DevOps Engineer và những người đang chuẩn bị cho kỳ thi CKA.
Trong đó, Pending, CrashLoopBackOff, ImagePullBackOff và OOMKilled là những tình huống phổ biến mà người học cần hiểu rõ về nguyên nhân, phương pháp kiểm tra và cách khắc phục. Mỗi lỗi phản ánh một nhóm vấn đề khác nhau, từ Scheduling, cấu hình ứng dụng, container image đến quản lý tài nguyên bộ nhớ.
Điều quan trọng nhất khi xử lý sự cố Kubernetes không phải là ghi nhớ thật nhiều câu lệnh, mà là hiểu cách hệ thống hoạt động và biết phân tích nguyên nhân dựa trên dữ liệu thực tế. Khi kết hợp kiến thức nền tảng với quá trình thực hành thường xuyên, người học sẽ từng bước phát triển khả năng quản trị và vận hành Kubernetes hiệu quả hơn.