

Trong quá trình phát triển ứng dụng Backend bằng Java Spring Boot, việc sử dụng Spring Data JPA giúp lập trình viên thao tác với cơ sở dữ liệu thông qua Entity và Repository mà không cần viết quá nhiều câu lệnh SQL thủ công. Tuy nhiên, sự tiện lợi này đôi khi khiến các vấn đề về hiệu suất truy vấn khó được nhận diện, đặc biệt là lỗi N+1 Query. Đây là tình trạng ứng dụng thực hiện một truy vấn ban đầu để lấy danh sách dữ liệu, sau đó tiếp tục phát sinh thêm nhiều truy vấn riêng lẻ để lấy thông tin liên quan của từng bản ghi. Khi dữ liệu tăng lên, số lượng truy vấn SQL có thể tăng nhanh, khiến API phản hồi chậm và gây áp lực lên database. Vậy làm thế nào để nhận biết lỗi N+1 Spring Data JPA thông qua SQL log và xác định đúng nguyên nhân? Việc hiểu cách Hibernate tạo truy vấn, đọc log SQL và lựa chọn chiến lược Fetching phù hợp sẽ giúp lập trình viên tối ưu hiệu suất ứng dụng hiệu quả hơn.
1. Lỗi N+1 Spring Data JPA là gì và cách nhận biết thông qua SQL log?
1.1. Cơ chế phát sinh lỗi N+1 trong Spring Data JPA
Lỗi N+1 Query là một vấn đề hiệu suất xảy ra khi ứng dụng cần thực hiện một truy vấn chính để lấy danh sách dữ liệu, sau đó phát sinh thêm N truy vấn để lấy dữ liệu liên quan của từng phần tử trong danh sách đó. Trong Spring Data JPA, vấn đề này thường xuất hiện khi sử dụng các quan hệ Entity như @OneToMany, @ManyToOne, @OneToOne hoặc @ManyToMany kết hợp với chiến lược Fetching chưa phù hợp.
Ví dụ, một hệ thống thương mại điện tử có hai Entity là Order và Customer. Mỗi đơn hàng thuộc về một khách hàng, được biểu diễn bằng quan hệ @ManyToOne. Khi lấy danh sách 100 đơn hàng, ứng dụng chỉ cần một truy vấn để đọc bảng orders. Tuy nhiên, nếu Hibernate phải tải thông tin khách hàng riêng cho từng đơn hàng, hệ thống có thể phát sinh thêm 100 truy vấn.
Đoạn code minh họa:
@Entity
public class Order {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String orderCode;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "customer_id")
    private Customer customer;
}
Repository thực hiện truy vấn danh sách đơn hàng:
public interface OrderRepository
        extends JpaRepository<Order, Long> {
}
Service lấy danh sách và truy cập thông tin khách hàng:
@Service
public class OrderService {

    private final OrderRepository orderRepository;

    public List<String> getOrderCustomers() {
        return orderRepository.findAll()
            .stream()
            .map(order ->
                order.getCustomer().getName()
            )
            .toList();
    }
}
Ở đây, findAll() lấy danh sách đơn hàng trước. Khi chương trình gọi order.getCustomer().getName(), Hibernate có thể thực hiện thêm truy vấn để tải Customer tương ứng nếu dữ liệu chưa được nạp. Nếu có 100 đơn hàng với 100 khách hàng khác nhau, tổng số truy vấn có thể lên đến 101.
Đây chính là lỗi N+1 Spring Data JPA. Cần lưu ý rằng nếu nhiều đơn hàng cùng tham chiếu đến một khách hàng, Hibernate có thể tận dụng dữ liệu đã được tải trong persistence context để giảm số truy vấn thực tế. Vì vậy, số lượng truy vấn còn phụ thuộc vào dữ liệu, cache và cách tổ chức Entity.
1.2. Cách bật SQL log Hibernate để phát hiện lỗi N+1 Spring Data JPA
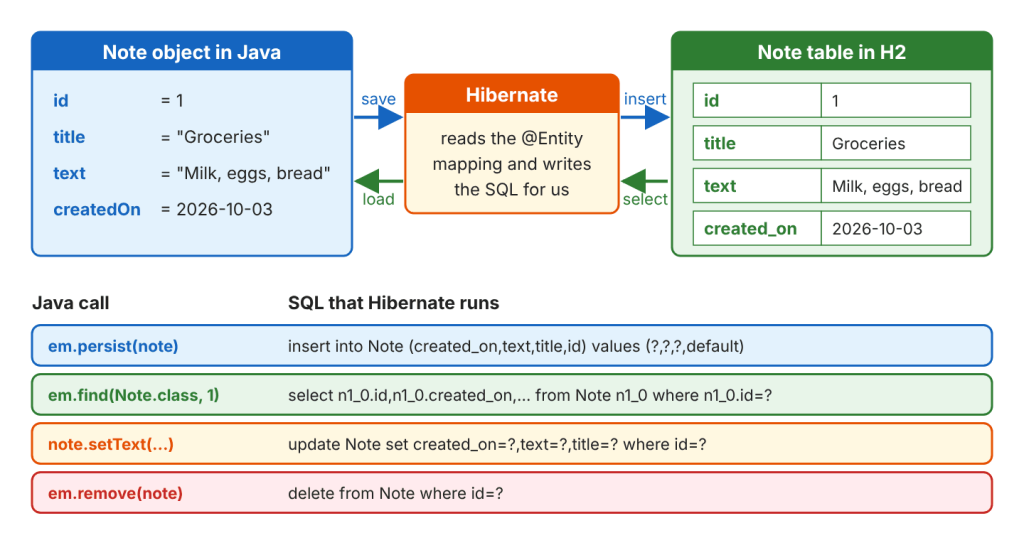
Một trong những cách đơn giản nhất để phát hiện lỗi N+1 Spring Data JPA là bật SQL logging của Hibernate. Thông qua log, lập trình viên có thể quan sát những câu lệnh SQL mà ORM thực sự gửi đến database, từ đó phát hiện các truy vấn bị lặp hoặc phát sinh không cần thiết.
Trong file application.properties, có thể cấu hình như sau:
# Hiển thị câu lệnh SQL
spring.jpa.show-sql=true

# Format SQL để dễ đọc
spring.jpa.properties.hibernate.format_sql=true

# Hiển thị SQL log
logging.level.org.hibernate.SQL=DEBUG

# Hiển thị giá trị parameter trong Hibernate 6
logging.level.org.hibernate.orm.jdbc.bind=TRACE
Trong đó, hibernate.format_sql giúp định dạng câu SQL dễ quan sát hơn. org.hibernate.SQL=DEBUG hiển thị các truy vấn được Hibernate thực thi. Với Hibernate 6, org.hibernate.orm.jdbc.bind=TRACE cho phép theo dõi giá trị được bind vào các tham số SQL.
Sau khi bật log, hãy thực hiện một request lấy danh sách đơn hàng. Nếu xuất hiện nhiều câu truy vấn có cấu trúc tương tự nhau, chỉ khác giá trị customer_id, đây có thể là dấu hiệu của N+1 Query.
Ví dụ, log SQL có thể hiển thị:
-- Truy vấn danh sách đơn hàng
SELECT *
FROM orders;

-- Truy vấn thông tin khách hàng thứ nhất
SELECT *
FROM customers
WHERE id = 1;

-- Truy vấn thông tin khách hàng thứ hai
SELECT *
FROM customers
WHERE id = 2;

-- Truy vấn thông tin khách hàng thứ ba
SELECT *
FROM customers
WHERE id = 3;
Nếu danh sách có nhiều đơn hàng, những câu truy vấn lấy Customer có thể tiếp tục xuất hiện tương tự. Thay vì lấy dữ liệu liên quan trong một lần truy vấn phù hợp, Hibernate đang thực hiện nhiều truy vấn riêng biệt.
Để xác định chính xác lỗi N+1 Spring Data JPA, lập trình viên nên chú ý ba dấu hiệu: một truy vấn chính lấy danh sách dữ liệu, nhiều truy vấn phụ có cùng cấu trúc SQL và số lượng truy vấn tăng theo số lượng bản ghi được xử lý. Không phải mọi truy vấn giống nhau đều là N+1, vì vậy cần đối chiếu log với luồng xử lý trong Service và quan hệ giữa các Entity.
Ngoài ra, spring.jpa.show-sql=true chỉ phù hợp khi phát triển và kiểm tra cục bộ. Trong production, nên sử dụng hệ thống logging có kiểm soát hoặc công cụ theo dõi truy vấn để tránh tạo quá nhiều log, làm lộ dữ liệu nhạy cảm và ảnh hưởng đến hiệu suất.
2. Cách xử lý lỗi N+1 Spring Data JPA và tối ưu truy vấn SQL
2.1. Sử dụng JOIN FETCH để lấy dữ liệu liên quan trong một truy vấn
Một trong những giải pháp phổ biến để xử lý lỗi N+1 Spring Data JPA là sử dụng JOIN FETCH trong JPQL. Cách này cho phép Hibernate lấy Entity chính và dữ liệu liên quan trong cùng một truy vấn, hạn chế việc phải thực hiện thêm nhiều câu SQL riêng lẻ.
Ví dụ, thay vì sử dụng Repository mặc định:
public interface OrderRepository
        extends JpaRepository<Order, Long> {
}
Có thể bổ sung truy vấn:
public interface OrderRepository
        extends JpaRepository<Order, Long> {

    @Query("""
        SELECT o
        FROM Order o
        JOIN FETCH o.customer
        """)
    List<Order> findAllWithCustomer();
}
Khi gọi findAllWithCustomer(), Hibernate sẽ tạo truy vấn SQL có JOIN giữa bảng orders và customers. Nhờ đó, thông tin khách hàng được tải cùng đơn hàng trong một lần truy vấn.
SQL được sinh ra có thể tương tự:
SELECT o.*, c.*
FROM orders o
JOIN customers c
    ON o.customer_id = c.id;
Thay vì một truy vấn lấy danh sách đơn hàng và nhiều truy vấn lấy khách hàng, hệ thống có thể lấy toàn bộ dữ liệu cần thiết thông qua một truy vấn JOIN phù hợp.
Tuy nhiên, JOIN FETCH cần được sử dụng đúng ngữ cảnh. Nếu sử dụng với quan hệ collection như @OneToMany hoặc @ManyToMany, dữ liệu JOIN có thể tạo ra nhiều dòng lặp cho Entity gốc. Điều này ảnh hưởng đến kích thước kết quả và cách phân trang. Đặc biệt, kết hợp fetch collection với pagination có thể khiến Hibernate phải xử lý phân trang trong bộ nhớ hoặc phát sinh cảnh báo. Vì vậy, cần cân nhắc thiết kế truy vấn riêng cho từng trường hợp thay vì sử dụng JOIN FETCH cho mọi quan hệ.
2.2. Sử dụng @EntityGraph và Batch Fetching để tối ưu truy vấn
Bên cạnh JOIN FETCH, Spring Data JPA còn hỗ trợ @EntityGraph, cho phép lập trình viên xác định những quan hệ cần được tải cùng Entity chính mà không cần viết JPQL JOIN FETCH trực tiếp.
Ví dụ:
public interface OrderRepository
        extends JpaRepository<Order, Long> {

    @EntityGraph(attributePaths = {"customer"})
    List<Order> findAll();
}
Với cách triển khai này, customer được đưa vào kế hoạch Fetching khi truy vấn danh sách đơn hàng. Hibernate có thể sử dụng JOIN hoặc chiến lược truy vấn phù hợp với cấu hình và ngữ cảnh để tải dữ liệu liên quan.
Ưu điểm của @EntityGraph là giúp tách biệt yêu cầu lấy dữ liệu khỏi định nghĩa quan hệ Entity. Cùng một Entity có thể được sử dụng trong nhiều trường hợp khác nhau, mỗi Repository method sẽ chỉ định những dữ liệu cần tải cho từng nghiệp vụ. Điều này giúp tránh việc thay đổi FetchType toàn cục chỉ để phục vụ một API cụ thể.
Một giải pháp khác là Batch Fetching. Thay vì tải dữ liệu liên quan cho từng Entity bằng từng truy vấn riêng lẻ, Hibernate có thể gom nhiều ID vào một câu lệnh SQL sử dụng IN.
Ví dụ cấu hình trong application.properties:
spring.jpa.properties.hibernate.default_batch_fetch_size=50Khi đó, thay vì thực hiện nhiều truy vấn như:
SELECT *
FROM customers
WHERE id = 1;

SELECT *
FROM customers
WHERE id = 2;

SELECT *
FROM customers
WHERE id = 3;
Hibernate có thể gom nhiều ID vào một truy vấn:
SELECT *
FROM customers
WHERE id IN (1, 2, 3);
Batch Fetching đặc biệt hữu ích khi cần tải nhiều quan hệ Lazy mà không muốn JOIN tất cả dữ liệu vào cùng một truy vấn. Tuy nhiên, nó không nhất thiết đưa tổng số truy vấn về một. Số lượng truy vấn còn phụ thuộc vào batch size, số lượng Entity cần tải và cách Hibernate quản lý persistence context.
Để lựa chọn giải pháp phù hợp, lập trình viên nên dựa trên cấu trúc dữ liệu và nhu cầu thực tế của API. JOIN FETCH phù hợp khi cần lấy dữ liệu liên quan trực tiếp trong một truy vấn. @EntityGraph phù hợp khi muốn khai báo kế hoạch Fetching linh hoạt theo từng Repository method. Trong khi đó, Batch Fetching hữu ích khi cần gom nhiều truy vấn tải quan hệ Lazy thành các nhóm nhỏ.
Ngoài việc áp dụng các giải pháp trên, cần chú ý đến một số nguyên tắc quan trọng để tránh lỗi N+1 Spring Data JPA tái diễn:
- Kiểm tra FetchType: Không nên mặc định chuyển tất cả quan hệ sang EAGER vì việc tải quá nhiều dữ liệu có thể làm tăng chi phí truy vấn.
- Theo dõi SQL log sau khi tối ưu: Cần thực hiện lại request và so sánh số lượng truy vấn trước và sau khi thay đổi.
- Sử dụng DTO Projection: Nếu API chỉ cần một số trường dữ liệu, có thể truy vấn trực tiếp DTO hoặc projection thay vì tải toàn bộ Entity.
- Kiểm tra phân trang: Với danh sách lớn, nên cân nhắc truy vấn hai bước: lấy ID của các bản ghi theo trang trước, sau đó tải dữ liệu liên quan cho nhóm ID đó.
- Đo lường hiệu suất: Có thể sử dụng Hibernate Statistics, datasource proxy hoặc công cụ theo dõi truy vấn để đánh giá số lượng SQL thực tế.
Kết luận
Lỗi N+1 là một trong những vấn đề hiệu suất thường gặp khi sử dụng Spring Data JPA và Hibernate, đặc biệt với những ứng dụng có nhiều quan hệ Entity. Việc đọc SQL log giúp lập trình viên nhận diện các truy vấn lặp, xác định nguyên nhân từ chiến lược Fetching và lựa chọn phương án tối ưu phù hợp. Thông qua JOIN FETCH, @EntityGraph, Batch Fetching và DTO Projection, hệ thống có thể giảm số lượng truy vấn SQL không cần thiết, cải thiện thời gian phản hồi API và hạn chế áp lực lên database. Nếu muốn nâng cao kỹ năng xây dựng ứng dụng Backend, làm chủ Spring Boot, Spring Data JPA, Hibernate và tối ưu hiệu suất truy vấn cơ sở dữ liệu, hãy tham khảo khóa học Backend Java Spring Boot tại BKACAD. Khóa học giúp bạn củng cố kiến thức Java Backend và từng bước vận dụng các kỹ thuật phát triển ứng dụng vào những dự án thực tế.

